

Niepewność prostej kalibracji: kowariancja, reszty i statystyka χ²
Dwa współczynniki dopasowanej prostej pochodzą z tych samych pomiarów. Nie można na ogół traktować ich jako niezależnych. Ten związek decyduje o niepewności przewidywanego napięcia, a reszty pomagają ocenić, czy sam model prostej wystarcza.
W tym materiale
Dwa współczynniki dopasowanej prostej pochodzą z tych samych pomiarów. Nie można na ogół traktować ich jako niezależnych. Ten związek decyduje o niepewności przewidywanego napięcia, a reszty pomagają ocenić, czy sam model prostej wystarcza.
Potrzebne wiadomości: Regresja ważona z niezależnymi znanymi niepewnościami, wariancja i liniowe przenoszenie niepewności. Kowariancja jest objaśniona w tekście.
Co się zmienia po powtórzeniu kalibracji?
W poprzedniej lekcji dopasowaliśmy Ū=aF+b. Wzorce Fi i ich zaniedbywalne niepewności pozostają takie same, ale nowe niezależne odczyty Ui dałyby trochę inne â i b̂. Kowariancja Cab jest średnią iloczynu odchyleń tych współczynników od ich wartości oczekiwanych. Dodatnia oznacza wspólne zmiany w tym samym kierunku, ujemna — w przeciwnych. Ma jednostkę V²/N; nie jest bezwymiarowym współczynnikiem korelacji.
Najłatwiej zacząć od siły środkowej
Zapiszmy tę samą prostą jako Ū=c+a(F−F̄w). Parametr c oznacza napięcie przy średniej ważonej sile. Ponieważ suma wi(Fi−F̄w) znika, otrzymaliśmy ĉ=Ūw. Z niezależności odczytów i wi=1/ui² wynika:
u^2(\widehat c)=\sum_i\left(\frac{w_i}{S}\right)^2u_i^2=\frac1S.
Czułość jest także liniową kombinacją odczytów. Współczynnik przy Ui wynosi wi(Fi−F̄w)/D. Po zsumowaniu wariancji otrzymujemy u²(â)=1/D. Kowariancja â z ĉ jest proporcjonalna do znikającej sumy wi(Fi−F̄w), więc wynosi zero.
Wracamy do b̂=ĉ−âF̄w. Ostatecznie:
u^2(\widehat a)=\frac1D,\qquad u^2(\widehat b)=\frac1S+\frac{\overline F_w^2}{D},\qquad C_{ab}=-\frac{\overline F_w}{D}.
Gdy wzorce mają dodatnie siły, większe nachylenie zwykle towarzyszy mniejszemu napięciu zerowemu: prosta może obrócić się blisko środka danych. Ujemna kowariancja nie jest wadą pomiaru. Wynika częściowo z wyboru początku osi. Przesunięcie osi do F̄w usuwa tę kowariancję, ale nie dodaje nowych danych.
Niepewność przewidywanej średniej i nowego odczytu
Przy dokładnie znanej sile F przewidywana średnia wynosi Û=âF+b̂. Propagacja z kowariancją daje:
u^2(\widehat U)=F^2u^2(\widehat a)+u^2(\widehat b)+2F C_{ab}=\frac1S+\frac{(F-\overline F_w)^2}{D}.
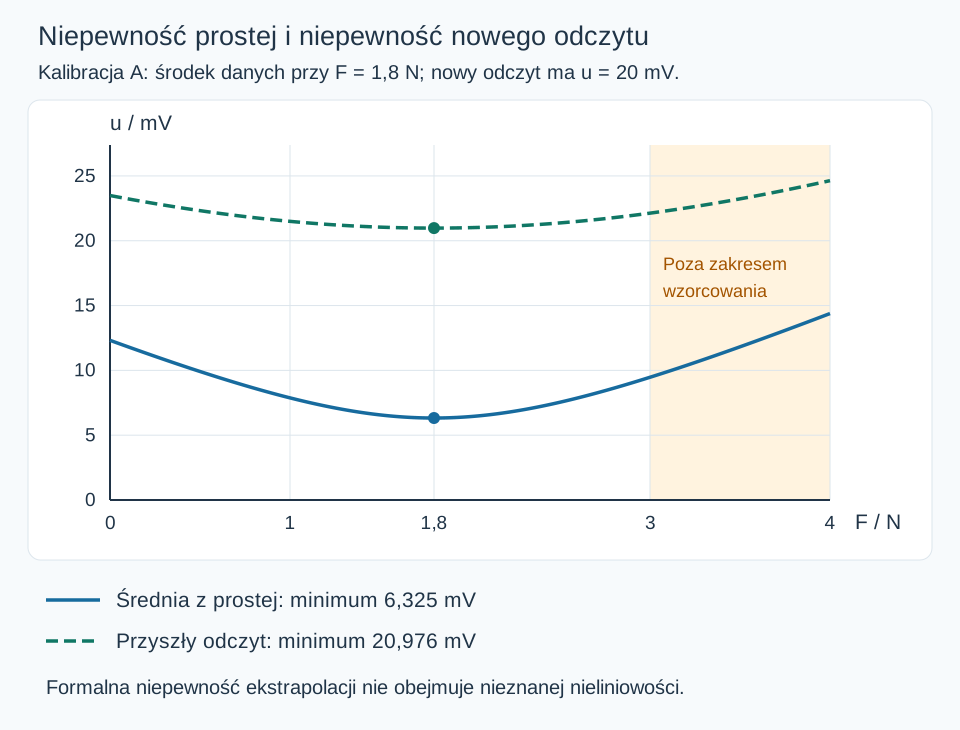
Ta niepewność jest najmniejsza w środku danych. Nie opisuje rozrzutu pojedynczego przyszłego odczytu. Jeśli taki odczyt ma dodatkową niezależną standardową niepewność unowe, niepewność jego przewidywania wynosi:
u_{\mathrm{przew}}=\sqrt{u^2(\widehat U)+u_{\mathrm{nowe}}^2}.
Kalibracja A z pierwszego zadania poprzedniej lekcji daje S=25 000 V−2, D=29 000 N²/V² i F̄w=1,8 N. W środku zakresu u(Û)=0,006325 V. Dla przyszłego odczytu o unowe=0,020 V otrzymujemy uprzew=0,020976 V. Niepewność przewidywania nie może być mniejsza od niezależnego składnika nowego odczytu.
Czy reszty są rozsądne?
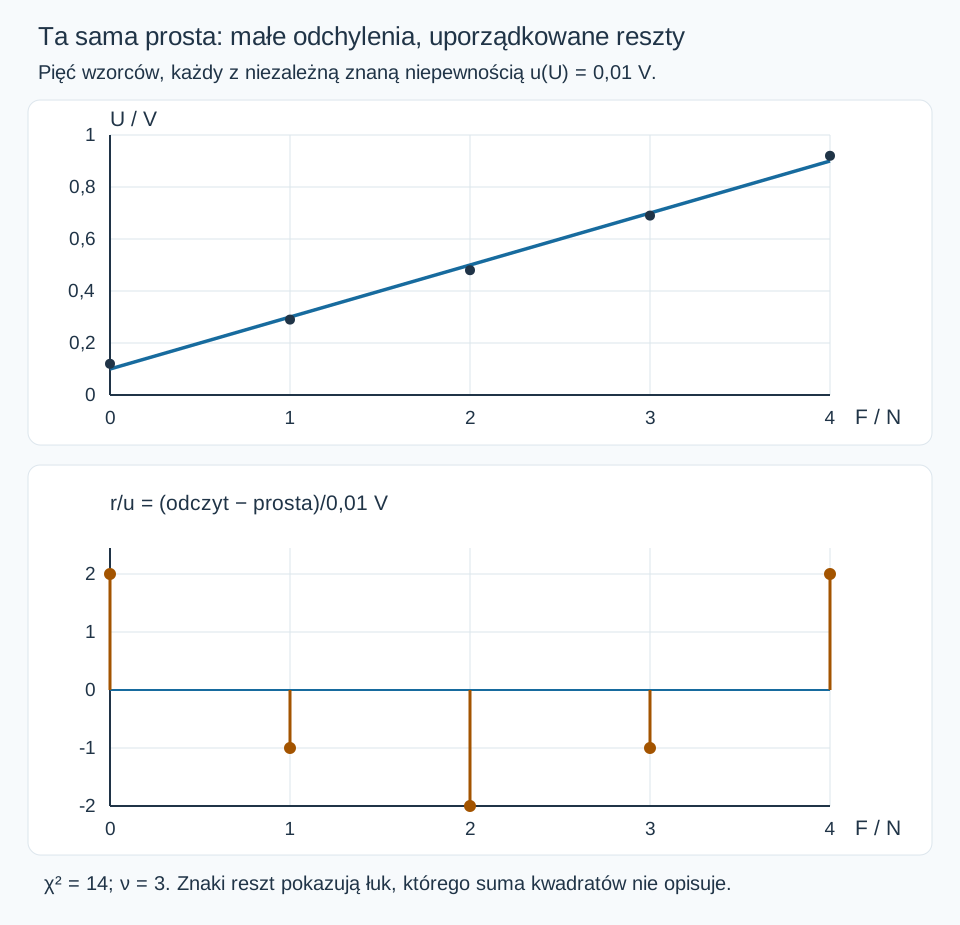
Po dopasowaniu liczymy ri=Ui−âFi−b̂ oraz χ²=Σ(ri/ui)². Jeżeli prosta jest poprawnym modelem średniej, odchylenia są niezależne i normalne, a ich wariancje naprawdę znamy, statystyka ma rozkład chi-kwadrat z ν=n−2 stopniami swobody. Dwa stopnie zużyliśmy na wyznaczenie a i b. Dla ν>0 wartość oczekiwana χ² wynosi ν, a wariancja 2ν. Iloraz χ²/ν bywa nazywany zredukowaną statystyką chi-kwadrat.
Nie oczekujemy dokładnie χ²/ν=1. Przy niewielkiej liczbie stopni swobody wahania są duże. Kalibracja A daje χ²≈2,224138 przy ν=2, czyli χ²/ν≈1,112069. Dla dwóch stopni swobody prawdopodobieństwo otrzymania co najmniej tak dużej statystyki w przyjętym modelu wynosi exp(−χ²/2)≈0,329. To nie jest prawdopodobieństwo, że model jest prawdziwy.
Reszty po dopasowaniu są powiązane warunkami minimum. Nie traktujemy ri/ui jako n nowych niezależnych zmiennych o wariancji 1. Oglądamy je również względem siły i kolejności pomiaru: łuk może sugerować nieliniowość, a trend czasowy — dryf. Sama suma kwadratów nie pokazuje kolejności znaków.
Nie poprawiamy założeń po to, żeby wynik wyglądał lepiej
W tych lekcjach ui są znane w modelu. Nie mnożymy automatycznie wariancji parametrów przez χ²/ν. Taka skala pojawia się w innym problemie: gdy znamy tylko względne wagi, a wspólną skalę wariancji dopiero szacujemy z reszt. Mieszanie obu sytuacji daje niepewności zależne od niewłaściwego założenia.
Duże χ² skłania do sprawdzenia modelu średniej, niepewności, zależności między odczytami i ewentualnych pomyłek. Bardzo małe χ² może wynikać z przypadku, zawyżonej oceny rozrzutu lub korelacji. Idealnie zerowe reszty nie usuwają wspólnego błędu zera. Do takiej kontroli potrzebny jest niezależny wzorzec lub osobna informacja o kalibracji.
Sprawdź się: dwa różne wzorce wyznaczają prostą dokładnie, więc χ²=0. Czy dowodzą liniowości czujnika? Nie: n−2=0 i nie ma tutaj ani stopni swobody do sprawdzenia reszt, ani pomiaru kontrolnego między wzorcami.
Zadania do tego tematu
- Obrót prostej wokół środka danych: dlaczego potrzebna jest kowariancja?
- Niewidoczny łuk na wykresie napięcia: reszty i test prostej
- Ten sam wynik χ² mimo wspólnego przesunięcia zera
Komentarze (0)
Nie ma jeszcze opublikowanych komentarzy. Rozpocznij rozmowę o tym materiale.
RSS komentarzy · Powiadomienia e-mail
Dodaj komentarz
Możesz komentować jako gość lub zalogować się, aby użyć danych konta. Utwórz konto